MassNet, 15억 스펙트럼을 AI 학습 자료로 — 신약 검증비는 어디서 줄까
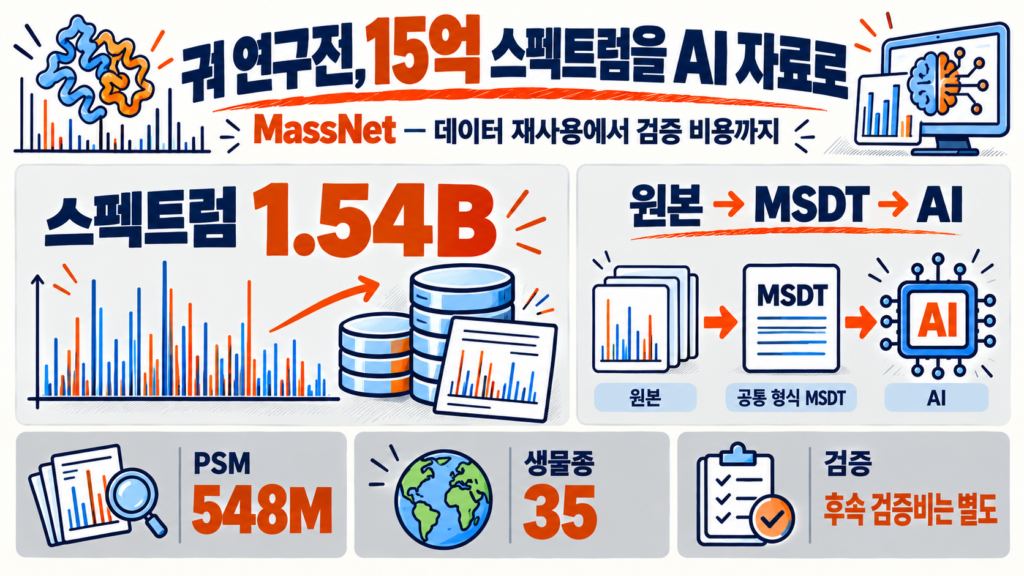
중국 웨스트레이크대학교의 톈난 궈(Tiannan Guo) 연구진이 만든 MassNet은 15억4천만 개의 질량분석 스펙트럼을 모은 AI 학습 자원입니다. 이미 측정한 단백질 자료를 더 잘 읽고 다시 활용하자는 시도입니다. 신약 연구비에 어떤 영향을 줄지는 데이터 준비와 후속 검증에 드는 비용을 나눠 봐야 이해할 수 있습니다. 출처: Guomics Lab — MassNet 공식 데이터 개요
고가의 장비로 시료를 측정했다고 해서 단백질의 정체가 저절로 드러나지는 않습니다. 측정 신호를 해석하고 결과가 맞는지 확인하는 작업이 남습니다. MassNet의 흥미로운 지점은 이 해석 작업을 여러 연구실이 같은 출발점에서 시작할 수 있게 한다는 데 있습니다.
톈난 궈 연구실, 코로나19 혈청 분석에서 AI 학습 자료로
궈 연구실은 단백질 데이터를 실제 질병 문제와 연결해 온 곳입니다. 2020년에는 코로나19 환자 혈청의 단백질과 대사물질을 분석해 중증도와 관련된 신호를 연구했습니다. 이번에는 개별 질병을 예측하는 모델보다 더 앞단인, 여러 모델이 함께 배울 자료를 만드는 문제에 접근했습니다. 출처: Westlake University — Guomics의 혈청 연구
공개 프리프린트에는 궈와 함께 푸단대학교·상하이 인공지능연구소의 쓰치 쑨(Siqi Sun), 상하이 인공지능연구소의 즈창 가오(Zhiqiang Gao)가 교신저자로 올라 있습니다. 공개 결과 자료에는 Jun A, Xiang Zhang, Xiaofan Zhang, Jiaqi Wei 등이 참여자로 기록돼 있습니다. 개별 연구자가 어떤 실험을 전담했는지는 최종 논문의 기여 명세를 확인하기 전에는 단정하지 않겠습니다. 출처: MassNet — 2025년 프리프린트 저자 정보 출처: 저자 공개 자료 — MassNet 연구진
MassNet이 모은 것은 단백질 15억 개가 아닙니다
단백질을 분석할 때는 짧은 조각인 펩타이드로 잘라 측정하는 방법을 많이 씁니다. 질량분석기는 전하를 띤 분자와 그 파편의 질량 대 전하 비율을 측정합니다. 파편이 어디에 얼마나 나타났는지를 기록한 신호가 스펙트럼입니다. 이 신호를 읽어 원래 펩타이드의 아미노산 순서를 추정합니다.
궈 연구진의 공식 개요는 스펙트럼 15억4천만 개와 PSM 5억4,800만 건을 제시합니다. PSM은 펩타이드 서열과 스펙트럼을 짝지은 기록입니다. 같은 서열이 여러 번 측정될 수 있으므로 이 숫자를 서로 다른 단백질 수로 읽으면 안 됩니다. 두 수치의 단순 비율도 모델의 정답률이 아닙니다. 출처: Guomics Lab — MassNet 공식 데이터 개요
공식 개요: 1,540M 스펙트럼·548M PSM. 고유 단백질 수나 정답률 비교가 아닙니다.
학습 자료가 커지면 여러 실험 조건에서 반복되는 특징을 배울 여지가 생깁니다. 반대로 특정 생물종이나 장비에 자료가 몰려 있으면 다른 조건에서 성능이 떨어질 수 있습니다. 궈 연구진의 자료를 도입할 연구실은 파일 개수보다 자기 시료와 얼마나 닮았는지를 먼저 봐야 합니다.
MSDT는 원시파일과 AI 사이의 정리 작업을 줄입니다
MassNet의 또 다른 축인 MSDT는 스펙트럼과 관련 정보를 일정한 항목에 담는 데이터 표현입니다. 여러 연구실의 서로 다른 서식을 같은 양식으로 정리하는 셈입니다. 공식 명세는 이를 Parquet라는 표 형태의 저장 방식으로 구현하며, 신호와 서열 정보 등을 재사용하기 쉽게 묶는다고 설명합니다. 출처: Guomics Lab — MSDT 형식 명세
Jun A와 Xiang Zhang 등이 공개한 자료에는 FragPipe와 Sage라는 검색 도구를 이용한 처리 절차도 포함됩니다. 서열을 배정하는 과정까지 추적할 수 있어야 다른 연구실이 결과를 비교하기 쉬워집니다. 공개 자료에는 시료가 분리 장치를 통과하는 시간의 예측, 이미 배정된 서열의 신뢰도 재평가를 위한 자료도 들어 있습니다. 출처: 저자 공개 자료 — 데이터 검색·후속 과제
-
1
원시 측정
원본과 실험 이력 보관
-
2
검색·정리
서열 후보와 신호 연결
-
3
MSDT
공통 항목으로 표현
-
4
모델 평가
자기 시료에서 성능 확인
다만 공식 명세는 MSDT가 장비의 원시파일이나 mzML 보관 형식을 대체하지 않는다고 선을 긋습니다. 장비 고유 정보를 모두 보존하는 형식도 아닙니다. 저장 비용을 아끼겠다며 원본을 지워 버리면 재분석이나 오류 추적에 필요한 정보를 잃을 수 있습니다. 비용 계산에는 원본 보관과 학습용 자료 보관이 함께 들어갑니다. 출처: Guomics Lab — MSDT 형식 명세
XuanjiNovo가 바꾸려는 서열 판독, 남아 있는 검증
기존 데이터베이스 검색은 알려진 서열 후보와 측정 신호를 맞춰 봅니다. 반면 de novo 시퀀싱은 신호에서 아미노산 순서를 직접 추정합니다. 후보 목록에 잘 잡히지 않는 서열을 탐색할 여지가 있지만, 잘못 제안한 서열을 걸러내는 일이 중요해집니다.
궈 연구진의 공개 코드에 따르면 XuanjiNovo는 1억 PSM을 학습에 사용한 비자기회귀 Transformer 모델입니다. 서열을 한 글자씩 순서대로 생성하는 방식과 달리 여러 위치를 함께 추정하는 구조입니다. 공개 모델을 가져다 자기 실험 자료에서 평가할 수 있다는 점이 도입 비용을 검토할 출발점입니다. 출처: Guomics Lab — XuanjiNovo 공개 코드
데이터베이스 검색
알려진 서열 후보
출발점
주요 제약 · 후보 목록의 범위
de novo 시퀀싱
측정된 파편 신호
출발점
주요 제약 · 추정 서열의 오류 확인
여기서 확인해야 할 결과는 ‘서열을 더 많이 제안했는가’만이 아닙니다. 오류 허용 수준을 같게 맞췄을 때 얼마나 많은 서열이 남는지, 학습에 없던 시료에서도 유지되는지, 추가 실험에서 맞는 것으로 확인되는지가 중요합니다. 궈 연구진의 모델이 유용하더라도 단백질의 양을 정확히 재거나 질병을 진단하는 능력까지 동시에 입증되는 것은 아닙니다.
신약 연구비는 어느 항목에서 줄어들 수 있을까
이제부터는 공개 연구 자원을 바탕으로 한 경제적 추론입니다. 궈 연구진의 자료가 실험실에서 같은 오류 수준을 유지하면서 더 유용한 정보를 뽑아낸다면, 이미 보유한 측정 자료를 다시 분석해 재측정 일부를 피할 수 있습니다. 자료 정리와 분석 프로그램 연결에 쓰던 인력 시간도 줄어들 가능성이 있습니다.
절감액은 피한 재측정비와 자료 준비비를 더한 뒤, 변환·저장·GPU 계산·추가 검증비를 빼야 나옵니다. 공개 모델을 이용하면 처음부터 대규모 학습을 할 필요는 줄어들 수 있습니다. 그래도 자기 장비와 시료에서 비교 실험을 하는 비용은 남습니다. GPU 구입비만 비교해서는 실제 도입 효과를 알 수 없습니다.
오히려 새로운 후보를 많이 찾으면 후속 실험비가 늘 수도 있습니다. 질병과 연관돼 보이는 단백질이 정말 유용한 지표인지 확인하려면 별도 검체와 분석이 필요하기 때문입니다. 같은 예산으로 확인된 후보를 더 많이 얻는다면 생산성이 오른 것입니다. 지출 총액이 반드시 줄어야만 성과인 것은 아닙니다.
Olink 31억 달러 인수가 보여 주는 단백질 데이터 수요
단백질 정보를 확보하려는 산업 수요는 이미 실제 거래로 나타났습니다. Thermo Fisher는 2024년 7월 Olink 인수를 완료했고, 취득 현금을 뺀 거래가치는 약 31억 달러였습니다. 회사는 Olink 기술을 자사의 질량분석 사업과 상호 보완적인 역량으로 설명했습니다. MassNet의 매출이나 시장가치를 뜻하는 숫자는 아닙니다. 출처: Thermo Fisher — Olink 인수 완료, 2024-07-10
UK Biobank도 2025년 1월 최대 5,400개 단백질을 60만 검체에서 측정하는 사업을 발표했습니다. 6월에는 정부 지원 2,000만 파운드를 추가로 발표했습니다. 이 사업에서 명시한 플랫폼은 Olink Explore HT입니다. 알려진 단백질을 대규모로 측정하는 사업과, 질량분석 신호에서 서열을 해석하는 MassNet은 해결하는 문제가 다릅니다. 출처: UK Biobank — 단백질 연구 착수, 2025-01-10 출처: UK Biobank — 정부 지원, 2025-06-23
궈 연구진의 공개 모델이 확산된다면 단순 서열 판독 소프트웨어의 가격에는 압력이 생길 수 있습니다. 대신 고객 시료에 맞춘 분석, 오류 관리, 검증 보고서를 제공하는 서비스에는 기회가 생길 수 있습니다. 이는 가능한 경쟁 구도의 변화이며, 기존 장비나 항체 기반 분석 시장을 대체했다는 증거는 아직 아닙니다.
한국 CRO·CDMO는 GPU보다 먼저 무엇을 확인해야 할까
한국의 CRO는 연구를 위탁받아 수행하는 기업이고, CDMO는 의약품 개발과 생산을 위탁받는 기업입니다. 궈 연구진의 자원을 검토한다면 보유한 DDA 자료부터 작은 규모로 비교할 수 있습니다. DDA는 측정 신호를 바탕으로 분석할 분자를 골라 파편화하는 수집 방식입니다. 다른 방식으로 얻은 자료에 같은 결과가 나올 것이라고 가정해서는 안 됩니다.
우선 기존 방법과 오류 허용 수준을 맞추고 확인된 서열 수, 검체당 처리 시간, 사람이 다시 검토한 시간, 추가 검증비를 기록하는 편이 합리적입니다. 결과가 안정적일 때 재분석 대상을 넓히면 됩니다. 특히 CDMO의 출하 품질검사에 쓰려면 탐색 연구에서 잘 작동했다는 사실 외에 시험법의 재현성과 변경 관리도 확보해야 합니다.
질병관리청 바이오뱅크 같은 공공 자원에서도 보관 검체가 있다는 사실과 재사용 가능한 질량분석 자료가 있다는 사실은 구별해야 합니다. 검체 이력, 이용 동의, 관련 임상정보와 실제 파일 형식을 먼저 확인해야 합니다. 이 글은 국내 기관의 MassNet 도입을 확인했다는 뜻이 아니라, 도입을 검토할 경우의 비용 조건을 제시한 것입니다.
앞서 다룬 RNA fingerprinting이 약물의 작용 후보를 좁히는 이야기였다면, 이번은 측정한 단백질 신호를 해석하는 기반의 이야기입니다. 가상 세포 연구와도 공통 질문이 있습니다. 예측이 늘어난 만큼 검증이 따라갈 수 있는지가 경제적 가치를 결정합니다. 관련: RNA fingerprinting과 신약 검증 관련: 가상 세포 STATE와 실험비
MassNet이 바꿀 수 있는 것은 장비 한 대의 가격보다 이미 쌓인 측정 자료에서 얻는 정보의 양입니다. 궈 연구진의 공개 자원이 연구실마다 되풀이하던 준비 작업을 줄이고, 남은 예산을 더 엄격한 검증에 쓸 수 있게 한다면 의미가 큽니다. 판단할 숫자는 스펙트럼 총량 다음에 나옵니다. 확인된 결과 한 건을 얻는 데 실제로 얼마가 들었는지입니다.
자료 확인 범위: 이 글은 연구진의 공식 데이터·코드·명세와 기관 발표를 근거로 작성했습니다. 지정된 Nature Methods 원문은 접근 제한으로 본문을 확인하지 못했습니다. 그래서 원문의 성능 향상 수치와 세부 평가 조건은 인용하지 않았고, 실험비 절감률도 제시하지 않습니다. 특정 기업·종목의 매수나 매도를 권하는 글이 아닙니다. 출처: MassNet — Nature Methods (원문 접근 제한)
MassNet의 경제성은 확인된 결과 한 건을 얻는 데 드는 전체 비용으로 판단해야 합니다.
출처와 참고 링크
- MassNet — Nature Methods (원문 접근 제한)
- Guomics Lab — MassNet 공식 데이터 개요
- Guomics Lab — MSDT 형식 명세
- Guomics Lab — XuanjiNovo 공개 코드
- Guomics Lab — 데이터·모델 배포
- 저자 공개 자료 — 데이터 검색·후속 과제
- 저자 공개 자료 — MassNet 연구진
- MassNet — 2025년 프리프린트 저자 정보
- Westlake University — Guomics의 혈청 연구
- Westlake University — Tiannan Guo
- Thermo Fisher — Olink 인수 완료, 2024-07-10
- UK Biobank — 단백질 연구 착수, 2025-01-10
- UK Biobank — 정부 지원, 2025-06-23
이 글은 정보 제공 목적이며, 특정 자산의 매수·매도를 권유하지 않습니다.
댓글 0