의료 AI 진료비 3.2배 — 아란팀이 계산한 AI 검사·의뢰 권고의 값
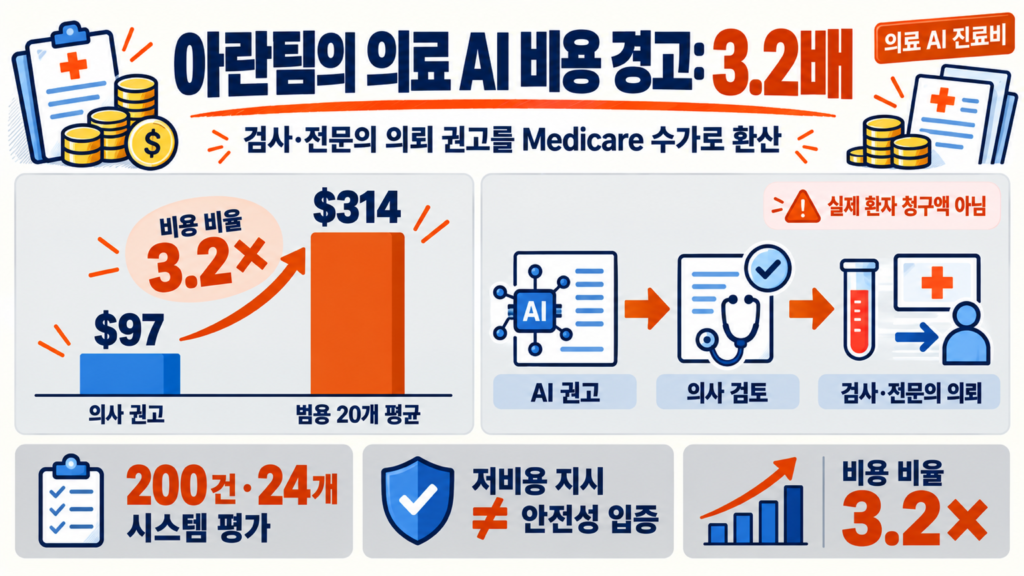
의료 AI 진료비는 의사의 시간만 줄인다고 내려갈까요? 이스라엘 테크니온의 드비르 아란(Dvir Aran)과 동료들이 비교한 범용 AI의 검사·전문의 의뢰 권고는 방문당 평균 314달러, 의사가 기록한 권고는 97달러였습니다. 약 3.2배의 차이를 보면 의료 AI를 병원에 들일 때 무엇까지 계산해야 하는지 알 수 있습니다. 출처: 논문 초록 / Abstract
먼저 이 숫자는 실제 환자가 낸 돈이 아닙니다. 두 종류의 진료 권고에 미국 공적 의료보험 Medicare의 2026년 수가를 붙인 비교입니다. 약값과 장기 치료비까지 합친 총진료비도 아닙니다. 이 구분을 놓치면 연구가 밝힌 위험을 오히려 과장하게 됩니다.
테크니온 임상 AI 연구실과 스탠퍼드 보건경제학자의 만남
아란은 테크니온 생물학부에서 임상 AI와 생물학 데이터를 연구하는 연구실을 이끌고 있습니다. 함께 논문을 쓴 스탠퍼드대 보건정책학자 제러미 골드하버파이버트는 의료 개입의 비용과 효과를 비교하는 연구를 해왔습니다. 모델이 답을 잘하는지에 더해 그 답을 실행하는 데 얼마나 많은 의료 자원이 필요한지를 묻기에 어울리는 조합입니다. 출처: Technion 연구자 소개 출처: Stanford 연구자 소개
공저자는 이타이 매니, 앤서니 응우옌, 대니얼 양, 샤하르 셸리입니다. 아란과 셸리는 앞서 응급실의 LLM 임상보조 시스템을 전향적으로 평가한 연구에도 참여했습니다. 이번에는 정확도 중심의 질문을 진료 계획의 경제성으로 넓혔습니다. 공개 자료만으로 개인별 실험·분석 분담까지 확인되지는 않아 특정 연구자에게 세부 작업을 귀속하지 않았습니다. 출처: 저자 명단·자료 출처: 관련 연구
논문은 2026년 10월 15일 NEJM AI에 공개됐습니다. 출판사 전문은 이번 조사에서 열리지 않아 스탠퍼드가 제공하는 논문 초록과 저자들의 공개 분석 자료를 대조했습니다. 따라서 본문이 확인하지 못한 보충자료의 세부 조건까지 검증한 것으로 읽어서는 안 됩니다. 출처: 게재일 / Publication date 출처: NEJM AI
의료 AI 진료비를 어떻게 비교했나
아란과 동료들은 공개 임상기록 모음인 MTSamples에서 비식별 외래·응급실 기록 200건을 사용했습니다. 의사가 평가와 계획을 적기 전까지의 정보를 AI에 주고 다음에 무엇을 할지 작성하게 했습니다. 사람 쪽 비교 대상은 같은 기록에 남아 있는 담당 의사의 계획이었습니다. 출처: 자료와 방법
평가 대상은 범용 시스템 20개와 의료 특화 시스템 4개였습니다. 연구진은 별도의 LLM 세 개로 검사·의뢰 주문을 추출해 같은 수가표를 적용했습니다. 새로운 진단 모델을 개발한 연구라기보다, 기존 모델이 만들어 내는 행동 목록에 가격을 붙인 평가 설계입니다. 이 연구는 의학 시험 정답률만으로는 보이지 않던 비용을 드러냈습니다. 출처: 논문 초록
범용 모델 평균은 앞서 본 314달러와 97달러였습니다. 논문이 보고한 평균 차이는 216달러입니다. 표시된 두 반올림 숫자를 빼면 217달러가 되지만 이를 논문의 차이 추정치로 바꾸어 쓰면 안 됩니다. 차이의 95% 신뢰구간은 177~257달러로 보고됐습니다.
범용 20개 시스템 평균. 방문당 2026 Medicare 수가 환산액이며 실제 청구액·약값·총진료비가 아닙니다. 출처: 논문 초록.
비용 차이는 검사에서 105달러, 전문의 의뢰에서 111달러가 발생했습니다. 검사 하나의 단가만 보는 것도 충분하지 않습니다. 의뢰는 다른 의사의 진료 시간과 예약 공간을 사용하기 때문입니다. 다만 그로 인한 대기시간 증가를 이 연구가 직접 측정하지는 않았습니다.
논문 보고 평균 차이의 구성. 반올림된 314−97의 단순 계산값과 구별합니다. · 축이 0이 아니라 100에서 시작합니다
검사를 하지 않는 판단을 AI는 배웠을까
아란팀 결과에서 눈여겨볼 숫자는 66%입니다. 이는 의사가 검사를 기록하지 않은 방문의 비율입니다. AI가 전체 방문의 66%에서 검사를 추가했다는 뜻은 아닙니다. 연구진은 이런 방문군에서 모든 시스템이 검사 추가를 제안하는 경향을 보였으며 흔히 비슷한 묶음 검사, 즉 패널 검사를 권했다고 보고했습니다.
패널 검사는 혈액검사처럼 여러 항목을 한 번에 묶어 주문하는 방식입니다. 증상을 설명하는 글을 충분히 쓰는 능력과, 지금 이 환자에게 필요한 항목만 고르는 능력은 다릅니다. 저자 공개 분석에서도 이 하위집단에 검사를 추가한 비율은 모델마다 달랐습니다. 따라서 “모든 모델이 모든 방문에서 검사했다”로 확대해 읽을 수 없습니다. 출처: 저자 공개 분석
이 결과를 방어적 의료, 곧 놓칠 가능성을 줄이려고 검사를 넓게 권하는 행동으로 해석할 수는 있습니다. 하지만 모델의 동기나 학습 원인을 입증한 실험은 아닙니다. 기록에 빠진 정보 때문에 추가 검사가 타당했을 가능성도 남습니다. 의사보다 비싸다는 사실만으로 모든 추가 권고가 불필요했다고 판정할 수는 없습니다.
“비용도 고려해”라는 지시로 해결될까
아란팀은 입력 지시문, 즉 프롬프트도 바꿨습니다. 비용을 고려하라는 조건에서는 의사 대비 비용이 2.5배, 안전을 유지하면서 진료를 절제하라는 조건에서는 1.4배였습니다. 지시 방식에 따라 비용은 분명히 달라집니다. 그렇다고 낮아진 비용이 곧 안전한 진료를 뜻하지는 않습니다. 출처: 초록의 프롬프트 비교
초록에 보고된 비교. 시간 추세가 아니며 안전성 동등성을 입증한 수치가 아닙니다.
이 연구는 실제 환자를 두 군으로 나누어 치료 결과를 추적한 임상시험이 아닙니다. 필요한 검사를 줄여 생긴 누락, 나중의 재방문, 입원까지 함께 확인해야 비용 절감을 말할 수 있습니다. “안전하게”라는 단어를 프롬프트에 넣는 것과 안전성을 측정하는 일은 별개입니다.
기록을 바탕으로 주문을 뽑아내는 과정에도 오차가 생길 수 있습니다. 세 개의 추출기를 쓴 설계가 그 문제를 살펴보는 데 도움이 되지만 모호한 권고가 실제 주문으로 바뀌는 방식까지 자동으로 해결하지는 못합니다. 비교 기준인 의사의 기록 역시 모든 판단과 실행 내용을 빠짐없이 담았다고 보장할 수 없습니다.
문서 작성은 빨라져도 병원 밖 비용은 늘 수 있습니다
아란팀의 질문은 이미 상용 제품 설계와 맞닿아 있습니다. Microsoft의 Dragon Copilot 문서는 의사가 진료 중 말한 주문 의도를 후보로 정리하고 전자의무기록 시스템인 EHR에서 검토하거나 주문을 찾도록 연결하는 기능을 설명합니다. 문장을 정리하는 AI가 실제 업무 화면에 들어오는 경로가 생긴 셈입니다. 출처: Microsoft 제품 문서
이 제품 기능은 AI가 독립적으로 진료 계획을 만든 이번 실험과 다릅니다. Dragon Copilot이 진료비를 3.2배 올렸다는 근거로 사용할 수 없습니다. 오히려 이 차이가 중요합니다. 의사가 이미 결정한 주문을 옮기는 도구인지, AI가 새 검사를 제안하는 도구인지에 따라 경제 효과가 달라질 수 있습니다.
아래는 논문 결과에서 출발한 도입 시나리오입니다. 기록 시간이 줄면 의료진은 환자 설명에 더 시간을 쓰거나 더 많은 환자를 볼 수 있습니다. 반대로 검토되지 않은 검사 후보가 기본 선택값으로 들어가면 이용량이 늘 수 있습니다. 병원의 업무 효율과 보험자의 총지출은 같은 방향으로 움직인다고 보장되지 않습니다.
-
1
검사·의뢰 후보
AI가 새로운 항목을 제안
-
2
의사 검토
필요성·중복·급여 조건 확인
-
3
실제 시행
승인된 검사·의뢰가 자원 사용
-
4
결과 평가
비용과 누락 진단·재방문 함께 확인
경제성을 계산할 때는 소프트웨어 구독료만 비교해서는 부족합니다. 절약한 업무시간의 가치에서 시스템 연동·검토 비용과 실제로 늘어난 검사·의뢰 비용을 빼야 합니다. 재방문과 환자 결과까지 포함하면 계산은 다시 달라집니다. 시간 절약이 자동으로 인건비 현금 절감이 되는 것도 아닙니다. 인력 운영이나 진료량이 실제로 달라져야 회계상 효과가 나타납니다.
한국에서는 수가와 주문 화면을 함께 봐야 합니다
골드하버파이버트가 다루는 비용효과 분석의 관점에서 보면, 한국 적용의 출발점은 미국 달러 숫자의 환산이 아닙니다. 심평원 설명처럼 한국의 행위별수가제는 서비스별 가격과 사용량으로 진료비를 보상합니다. 포괄수가 등 다른 방식도 함께 운영됩니다. 같은 검사라도 적용 수가와 급여 조건, 진료 경로가 달라 Medicare의 3.2배를 한국 건강보험 지출 증가율로 옮길 수 없습니다. 출처: 심평원 지불제도 안내
한국 EMR이나 임상보조 챗봇에 적용한다면, 추가 검사 후보가 의사 승인 없이 주문 단계로 넘어가는지부터 살펴야 합니다. 건강보험 급여 기준을 확인하도록 연결하면 불필요한 청구를 줄이는 데 도움이 될 수 있습니다. 다만 삭감될 청구를 걸러내는 일과 환자에게 필요한 진료를 판단하는 일은 같지 않습니다. 두 기준을 따로 검증해야 합니다.
아란팀 결과를 한국에서 시험하려면 실제 진료에 영향을 주지 않는 사전 평가부터 시작할 수 있습니다. 국내 기록과 수가로 권고를 계산하고 의사가 추가 제안을 얼마나 받아들이는지 확인한 뒤, 도입 전후의 검사량·재방문·누락 진단을 함께 추적하는 방식입니다. 국가 의료비에 미칠 크기는 보급률과 채택률, 환자 구성에 달려 있습니다. 이번 연구만으로 그 증가액을 계산할 수는 없습니다.
의료 AI 시장에서 새로 팔아야 할 것은 무엇일까
아란과 동료들의 연구는 평가·검증 사업의 가능성도 보여줍니다. EMR 업체는 주문마다 근거와 예상 비용을 보여주는 기능을, 평가 업체는 모델이 바뀔 때 검사·의뢰 성향이 달라지는지 확인하는 서비스를 제공할 수 있습니다. 이는 시장 가능성을 내다본 분석입니다. 이 논문이 해당 서비스의 매출 성장이나 수익성을 입증하지는 않았습니다.
실제로 연구진 관련 MEDBAR.ai는 연구 소개 페이지에서 기관 자체 환자군으로 모델을 비교하는 서비스를 제시합니다. 연구와 사업의 연결을 보여주는 자료이면서 이해관계를 감안해 읽어야 할 자료이기도 합니다. 이 회사의 홍보를 독립적인 임상 효과 검증으로 받아들이지는 않았습니다. 출처: MEDBAR.ai 서비스 설명
기존 산업의 대체도 업무별로 나눠 볼 필요가 있습니다. 기록 입력이나 주문 검색의 일부는 자동화할 수 있지만 이 실험은 의사를 대체할 수 있다는 증거를 주지 않습니다. 경쟁력이 생길 제품은 권고를 많이 만드는 제품보다, 필요한 권고를 의사가 검토하기 쉽게 만들고 그 결과까지 확인하는 제품일 가능성이 있습니다.
앞서 다룬 MedGemma 글과 이어 읽으면, 모델의 의료 과제 성능과 병원 도입 후 경제성이 서로 다른 검증 과제라는 점이 더 선명해집니다. 모델을 만드는 쪽의 비용은 바이트 LLM 전환 연구 글에서 다뤘는데, 이번 연구는 모델을 쓴 뒤 병원과 보험자 쪽에 생기는 비용을 본다는 점이 다릅니다. 관련: 관련 글: MedGemma
아란팀이 남긴 질문은 단순합니다. AI가 제안한 검사를 실제로 시행했을 때 환자는 더 나아지고 의료진의 시간과 의료비는 함께 줄어드는가입니다. 3.2배는 그 답이 아닙니다. 그 답을 확인하기 전에 주문 목록을 그대로 실행해서는 곤란하다는 출발점입니다.
의료 AI의 경제성은 권고가 실제 주문과 환자 결과로 이어지는 과정에서 검증해야 합니다.
출처와 참고 링크
- Aran et al., NEJM AI — Comparative Cost of Care Recommended by Large Language Models versus Treating Physicians
- Stanford — Jeremy Goldhaber-Fiebert 프로필 및 해당 논문 초록
- Dvir Aran — 연구 데이터와 분석 코드
- 저자 공개 분석 수치 — paper_numbers.md
- MEDBAR.ai — Ask for the Bill
- MEDBAR.ai — 연구진의 관련 논문 목록
- American Technion Society — Dvir Aran
- UCSF CODEX — 논문 게재일 목록
- Microsoft — Dragon Copilot 주문 관리
- 건강보험심사평가원 — 우리나라 진료비 지불 제도
이 글은 정보 제공 목적이며, 특정 자산의 매수·매도를 권유하지 않습니다.
댓글 0